

Introducción
La genética cardiovascular dejó de ser un tema limitado a enfermedades hereditarias poco frecuentes, para comenzar a integrarse progresivamente en la práctica clínica cotidiana. Hoy, conceptos como susceptibilidad genética, variantes modificadoras y riesgo poligénico forman parte creciente de la interpretación cardiovascular. Sin embargo, la relación entre genética y enfermedad cardiovascular rara vez es lineal. La misma variante puede expresarse de manera diferente entre individuos y muchas enfermedades frecuentes resultan del efecto acumulativo de múltiples variantes de pequeño impacto junto con factores ambientales.
En este contexto, el desafío para el cardiólogo clínico ya no consiste sólo en identificar mutaciones, sino en comprender cómo la información genética puede ayudar a interpretar mejor el riesgo, la heterogeneidad fenotípica y la variabilidad.
Del genotipo al fenotipo: penetrancia, expresividad y modificadores
La presencia de una variante genética no determina necesariamente una expresión clínica uniforme. Pacientes con el mismo genotipo pueden presentar diferencias en penetrancia, gravedad, edad de inicio y órganos comprometidos, reflejando la influencia de factores modificadores o condicionantes, genéticos, epigenéticos y ambientales sobre el fenotipo final. (Figura 1). (1)
Fig. 1
Esquema conceptual de la relación entre genotipo y fenotipo en enfermedades hereditarias
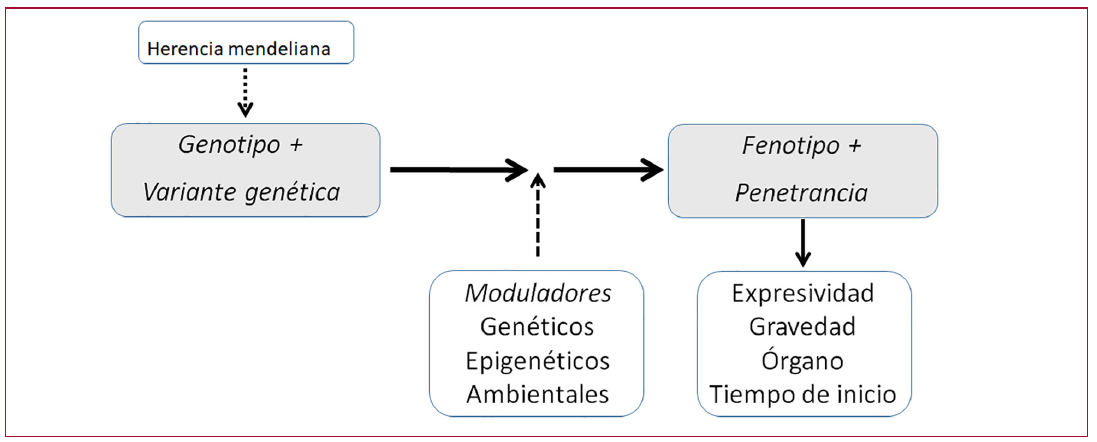
Una variante genética con posible patrón mendeliano puede asociarse a un fenotipo positivo con penetrancia variable. La expresión fenotípica final puede ser modulada por factores genéticos, epigenéticos y ambientales, condicionando diferencias en expresividad, severidad, órgano comprometido y edad de inicio
Las variantes monogénicas suelen asociarse a alta penetrancia y fenotipos de menor frecuencia poblacional y mayor magnitud de efecto biológico, lo que facilita su reconocimiento clínico y familiar. En contraste, las variantes poligénicas están constituidas por múltiples polimorfismos de nucléotido único (SNPs) de pequeño efecto individual, frecuentes en la población general y con una expresión fenotípica más gradual y probabilística.
Ambas, monogénicas y poligénicas, representan extremos de un continuo biológico más que entidades completamente separadas, de modo que en la práctica clínica ambos mecanismos suelen interactuar. Incluso en enfermedades consideradas monogénicas, la penetrancia y expresividad pueden ser modificadas por variantes poligénicas, mecanismos epigenéticos y factores ambientales. Esto contribuye a explicar la heterogeneidad clínica observada entre pacientes portadores de una misma variante genética, incluyendo diferencias en gravedad, edad de inicio y compromiso orgánico (Figura 2). (2)
Fig. 2
Variantes monogénicas de efecto fuerte o moderado y poligénicas asociadas por sumatoria de SNPs
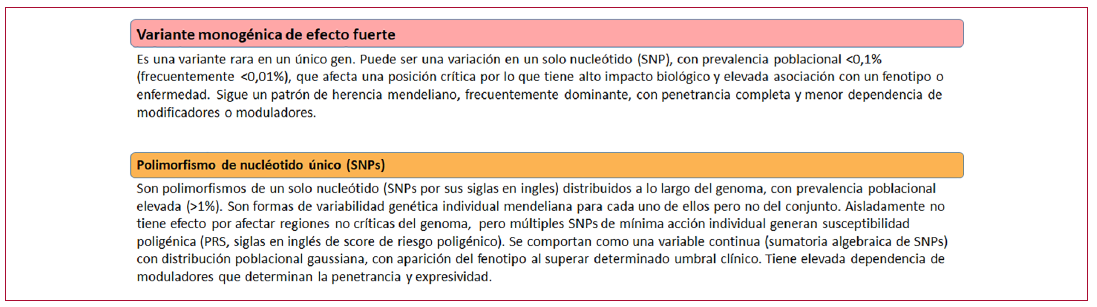
Se describen las características diferenciales de las variantes monogénicas y poligénicas según penetrancia, frecuencia poblacional, magnitud del efecto biológico y patrón de distribución fenotípica.
Un posible tercer grupo es una variante monogénica de efecto intermedio con características intermedias entre las categorías anteriores.
Las alteraciones genéticas pueden originarse por el cambio de una sola base del ácido desoxirribonucleico (ADN), aunque su impacto clínico depende fundamentalmente de la localización funcional comprometida. Las variantes localizadas en regiones críticas de un gen pueden modificar aminoácidos esenciales y asociarse a alteraciones estructurales o funcionales relevantes de la proteína. En contraste, muchos SNPs frecuentes presentan efectos biológicos pequeños o neutros y suelen actuar de manera combinada y probabilística a través de múltiples genes. (Figura 3) (3)
Fig. 3
Esquema conceptual de la organización estructural y funcional del ADN y los genes.
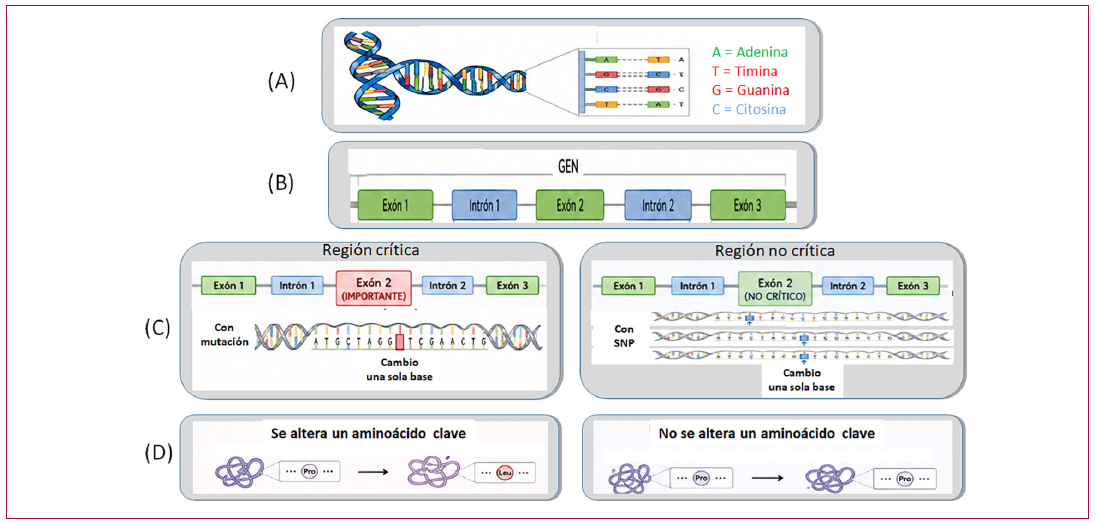
(A) Estructura de doble hélice del ADN y apareamiento de las bases nitrogenadas, adenina (A), timina (T), guanina (G) y citosina (C).(B) Representación esquemática de un gen, unidad funcional del ADN, compuesta por exones e intrones.(C) A la izquierda, ejemplo de sustitución de una sola base en una región funcional crítica de un único gen, capaz de alterar un aminoácido clave y modificar la estructura o función proteica.(C) A la derecha, ejemplo conceptual de SNPs localizados en regiones de menor impacto funcional y distribuidos en diferentes genes (se ejemplifican tres), que individualmente pueden no producir alteraciones relevantes de la proteína resultante.
(D) Repercusión estructural y funcional según se afecte o no un aminoácido clave
Como se señaló, la expresión clínica de las enfermedades con base genética no responde a un único modelo biológico, sino a un espectro continuo de arquitecturas genéticas. Algunas entidades están dominadas por variantes monogénicas de gran efecto y elevada penetrancia, mientras que otras dependen de la interacción acumulativa de múltiples variantes de menor impacto individual. Entre ambos extremos existen modelos intermedios en los que diferentes alteraciones genéticas relevantes contribuyen conjuntamente al fenotipo.
Esta heterogeneidad ayuda a explicar las diferencias observadas en edad de inicio, severidad, progresión y compromiso orgánico entre pacientes con diagnósticos aparentemente similares. (Figura 4). (4)
Fig. 4
Modelo conceptual de carga genética y umbral de enfermedad
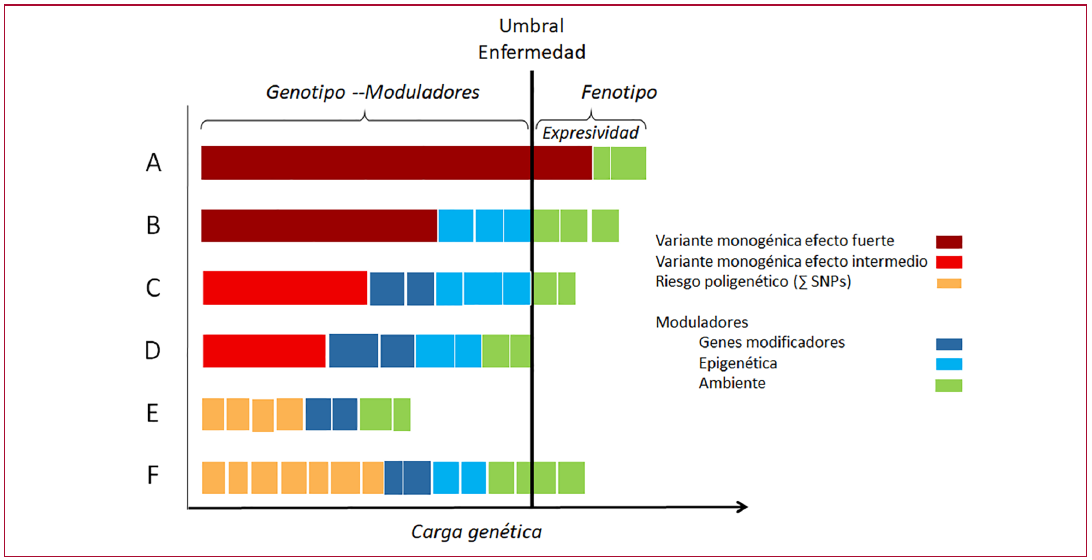
(A) Modelo monogénico clásico, dominado por una variante genética principal de alta penetrancia y gran efecto biológico, con escasa influencia de modificadores genéticos, epigenéticos y ambientales.(B) Modelo monogénico, en el que una variante genética principal con penetrancia incompleta interactúa con modificadores, determinantes de la expresividad clínica.(E y F) Modelo poligénico determinado por el efecto acumulativo de numerosos SNPs de pequeño efecto individual distribuidos en diferentes genes asociados a modificadores que permiten en (F), pero no en (E) alcanzar el umbral de penetrancia)
(C) y (D) representan variantes monogénicas de efecto intermedio
En resumen, el impacto clínico de una variante genética en el diagnóstico / pronóstico queda condicionado a:
patrón de herencia: dominante / recesivo
daño funcional de la variante
sector crítico del gen
tipo de mutación: sustitución, deleción, inserción.
penetrancia / expresividad: modificadores, genéticos, epigenéticos y ambientales.
Distribución poblacional de la carga genética y de la expresión fenotípica
El concepto de carga genética representa la integración de la variante principal y modificadores condicionantes de la penetrancia y expresividad fenotípica; en general, en los estudios clínicos suele constituir una estimación derivada de múltiples entradas genéticas más que un input aislado
En las variantes monogénicas, la limitada superposición entre distribuciones de la carga genética con sin fenotipo indican una adecuada discriminación y elevada especificidad.
Aun así, el riesgo estimado se eleva significativamente solo cuando alcanza expresividad clínica. En otras palabras, genotipo positivo con fenotipo negativo, en la mayoría de los casos, no es un condicionante que por sí solo defina conductas de intervención. (Figura 5)
Por otro lado, la reducida sensibilidad, propia de indicadores con baja prevalencia poblacional, indica que su ausencia no excluye enfermedad ni riesgo clínico. Por ello, la información genética debe integrarse con variables clínicas para una adecuada estratificación diagnóstica y pronóstica.
Fig. 5
Distribución de la carga genética en variantes monogénicas y poligénicas.
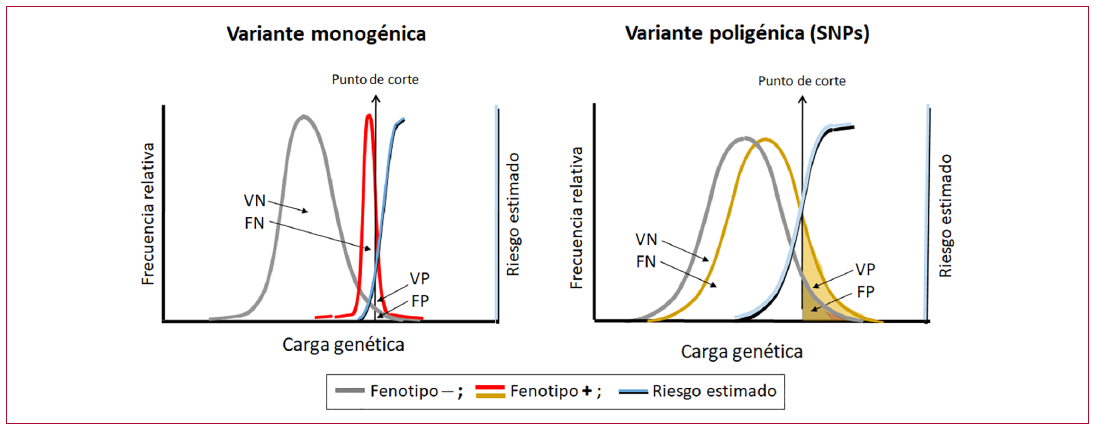
A la derecha se grafica la distribución gaussiana (demostrada para los scores de riesgo poligénico, de la carga genética en relación con un criterio fenotípico (ej., LDL-colesterol, presión arterial, etc.) o con un riesgo estimado (ej., evento vascular, fibrilación auricular, etc). Con fines comparativos, a la izquierda se representa la distribución teórica de variantes monogénicas de penetrancia alta e intermedia.
En ambos paneles, las distribuciones se representan esquemáticamente como gaussianas, bajo la premisa de que la carga genética resulta de la interacción entre la variante principal y múltiples modificadores genéticos, epigenéticos y ambientales que condicionan la penetrancia y la expresividad, confiriéndole el comportamiento de una variable continua.
En las enfermedades poligénicas, la mayor dispersión de la curva refleja el efecto acumulativo de múltiples variantes de pequeño efecto y de sus modificadores
asociados, mientras que su superposición indica una menor capacidad discriminativa.
En las variantes poligénicas el punto de corte balancea sensibilidad ( 70%) y especificidad ( 80%); en las monogénicas, la especificidad suele ser elevada (>90%), mientras que la sensibilidad poblacional es menor (<25%) debido a su baja prevalencia.
El riesgo estimado (representado por una curva sigmoidea derivada de una regresión logística) aumenta progresivamente con la carga genética y con la probabilidad de presentar el fenotipo.
VP: verdaderos positivos; FP: falsos positivos; VN: verdaderos negativos; FN: falsos negativos.
La figura tiene una finalidad exclusivamente conceptual y no representa distribuciones epidemiológicas exactas.
Por el contrario, las variantes poligénicas resultantes de múltiples polimorfismos de un solo nucleótido (SNPs), presentan una distribución típicamente gaussiana. La dispersión, al igual que la discriminación entre fenotipos negativos y positivos, es mucho menor, con curvas más amplias y mayor superposición, condiciones asociadas a los modificadores de la penetrancia. (Figura 5)
A diferencia de las monogénicas, en las variantes poligénicas es posible seleccionar un punto de corte con especificidad y sensibilidad balanceadas. También en este caso, el riesgo se acentúa significativamente con el fenotipo positivo, aunque la pendiente de incremento es menor. (Figura 5) (5)
Predicción genética de fenotipos subclínicos y clínicos.
En ensayos diagnósticos y pronósticos, la variante genética sola o integrada con factores de riesgo adquiridos, es la variable predictora, y el fenotipo subclínico o clínico, el riesgo estimado. En otros términos, el genotipo constituye el input o variable independiente del modelo, mientras que el fenotipo representa el output o variable dependiente.
La Figura 6 detalla variados fenotipos utilizados como outputs en estudios clínicos de genética predictiva en cardiología. Los subclínicos pueden analizarse como variables continuas o dicotomizadas, mientras que los fenotipos clínicos suelen expresarse como variables discretas correspondientes a enfermedades o complicaciones. (2-6)
Fig. 6
Fenotipos subclínicos y clínicos como outputs de predicción genética
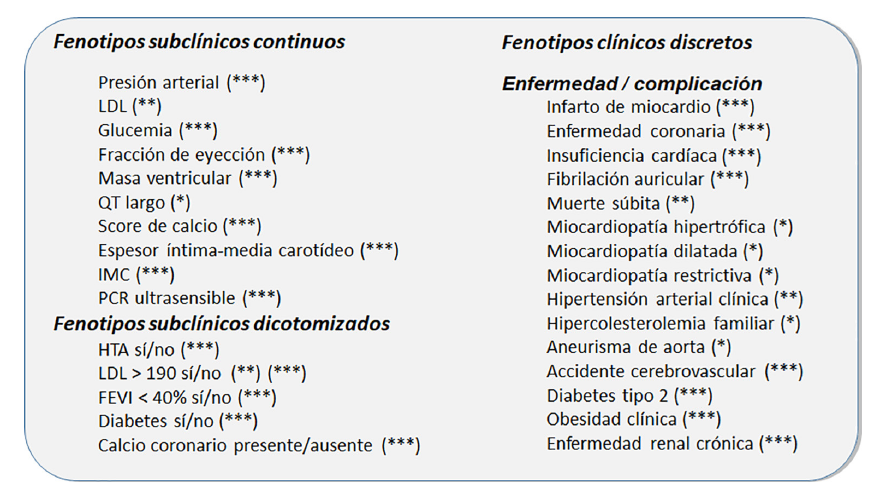
Se detallan los fenotipos explorados en ensayos clínicos. Los fenotipos subclínicos pueden analizarse como variables continuas o dicotomizadas, mientras que los fenotipos clínicos suelen expresarse como variables discretas correspondientes a enfermedades o sus complicaciones.
Se indica, la magnitud de la contribución genética relativa en diferentes genotipos: * monogénicas fuertes; ** monogénicas y poligénicas; *** poligénicas
Asociación simple, performance pronóstica e inteligencia artificial
Las asociaciones entre variantes genéticas y fenotipos, comunicadas desde centros de referencia, no implican necesariamente utilidad pronóstica en poblaciones generales. En general, este tipo de estudios constituye una etapa inicial que permite conocer la prevalencia o incidencia de una o variadas mutaciones. La aplicabilidad clínica requiere evaluar posteriormente la capacidad predictiva real mediante cohortes prospectivas y seguimiento longitudinal. (Figura 7)
Fig. 7
Asociación simple versus performance pronóstica genética.
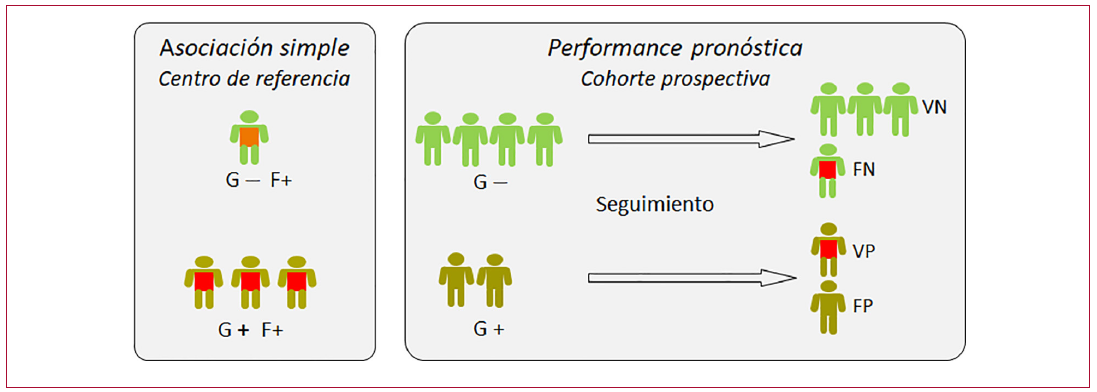
Izquierda: la asociación entre variante genética (G+) y fenotipo (F+) en centros de referencia refleja el enriquecimiento de casos, resultante de una derivación selectiva, pero sin estimación de la capacidad predictiva.
Derecha: en cohortes prospectivas, el seguimiento clínico permite estimar verdaderos positivos (VP), verdaderos negativos (VN), falsos positivos (FP) y falsosnegativos (FN), y así evaluar la performance pronóstica de la variante genética.
Desde el punto de vista clínico, los estudios de performance pronóstica permiten determinar si un marcador genético identifica adecuadamente individuos que desarrollarán la enfermedad, estimando sensibilidad y especificidad y los valores predictivos positivo y negativo. Este paso es esencial antes de incorporar variantes genéticas a modelos de predicción de riesgo o a decisiones clínicas individuales. (7)
La inteligencia artificial permite integrar simultáneamente grandes volúmenes de información genética, biológica y clínica, superando las limitaciones de los modelos estadísticos convencionales basados en pocas variables. (Figura 8)
Fig. 8
Esquema conceptual de un modelo de inteligencia artificial aplicado a predicción clínica.
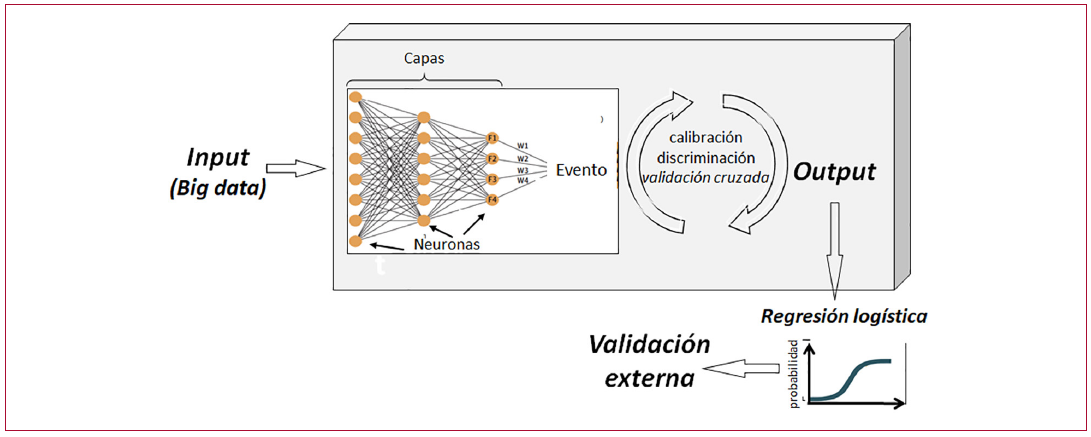
Múltiples posibles variables de entrada (inputs) son procesadas mediante capas interconectadas de una red neuronal artificial. Cada capa está graficada por puntos amarillos, cada uno de los cuales representa una “neurona”. Partiendo de alrededor de un millón de SNPs (rango habitual 500.000-2.000.000) como covariables de entrada, a IA genera en cada neurona múltiples ecuaciones de regresión múltiple ajustadas a la predicción del evento. En las primeras capas (por ejemplo, 100 ecuaciones construidas a partir de aproximadamente 1 millón de covariables cada una [F1 x W1); F2 x W2 ; F1millón x W1millon], donde P es SNP y W el peso asignado). En las capas sucesivas de va reduciendo progresivamente la información hasta obtener unas pocas variables latentes en la etapa
final (por ejemplo 20, [F1 x W1) ; F2 x W2 ; F20 x W2]). La integración de estas funciones genera un score continuo que posteriormente es transformado en una probabilidad estimada del evento o enfermedad (output).
En el proceso se estima el desempeño predictivo del modelo mediante la evaluación de validación interna, calibración y discriminación, con el objetivo de reducir errores derivados de múltiples comparaciones y mejorar la generalización del modelo.
La aplicabilidad clínica final requiere, además, de validación externa para poder generalizar sus conclusiones.
Sin embargo, el aumento de complejidad incrementa el riesgo de asociaciones espurias y sobreajuste, especialmente debido al elevado número de comparaciones simultáneas.
Por este motivo, la utilidad clínica de un modelo no depende únicamente de su capacidad de predicción, sino también de la adecuada calibración, discriminación y validación metodológica durante el denominado entrenamiento en inteligencia artificial.
La validación externa constituye además un requisito fundamental antes de trasladar estos modelos a la práctica clínica, para corregir probables errores resultantes de múltiples comparaciones, pero, sobre todo, para asegurar reproducibilidad y generalización en poblaciones diferentes. (8)
CONCLUSIONES
Suele considerarse que las variables genéticas se comportan en forma dicotómica (presencia/ausencia), pero este concepto no explica la complejidad cuando la información genética se traslada a la práctica clínica.
La carga genética es un concepto teórico que integra múltiples factores: patrón de herencia (dominante/recesivo), daño funcional de la variante (sector crítico o no crítico del gen) y penetrancia (completa/incompleta), condicionados por modificadores genéticos, epigenéticos y ambientales.
Los modificadores ambientales pueden no incluirse dentro del concepto estricto de carga genética, y considerarse factores adicionales que mejoran la capacidad predictiva de los modelos clínicos.
Las variables genéticas incluyen básicamente dos grandes grupos:
variables monogénicas de efecto fuerte o moderado (prevalencia <1%), con patrón mendeliano de transmisión.
variables poligénicas (PRS, siglas en inglés de polygenic risk score), definidas por la sumatoria de múltiples SNPs (prevalencia >1%).
En enfermedades monogénicas con fondo poligénico, la incorporación de SNPs mejora la estimación del riesgo.
Como cualquier marcador biológico, la carga genética con finalidad diagnóstica o pronóstica debe interpretarse dentro de las reglas generales de evaluación de cualquier test biológico.
En los scores poligénicos, sensibilidad, especificidad, valor predictivo positivo y valor predictivo negativo son los parámetros que permiten definir la utilidad clínica del test genético. En general, la información genética se integra a scores clínicos convencionales.
En sujetos con genotipo positivo, la aparición de expresión fenotípica aumenta significativamente la probabilidad de enfermedad. Por el contrario, un fenotipo negativo aislado tiene un valor limitado, aspecto crítico en el traslado de la información genética a la toma de decisiones médicas.
La inteligencia artificial amplía y facilita el análisis de grandes volúmenes de información genética; sin embargo, sus fundamentos interpretativos continúan basándose en los principios clásicos de la estadística y la probabilidad.
El análisis de big data incrementa significativamente el riesgo de falsos positivos debido a comparaciones múltiples y sobreajuste estadístico. Por ello, la validación externa resulta fundamental para confirmar la consistencia y reproducibilidad de los hallazgos iniciales.